Vai al contenuto
In questo articolo troverai:
- Come utilizzare KNIME per la data preparation e l’ottimizzazione dei processi ETL
- Come integrare KNIME con le moderne Data Platform e le tecnologie AI
- I vantaggi della data preparation indipendente per il Business Process Reengineering
- Come automatizzare la pulizia dei dati e ridurre gli errori nei processi aziendali
- Come sviluppare workflow di Data Science per analisi predittive e applicazioni AI
Nel moderno ecosistema della data engineering e dell’AI DATA CORE, le organizzazioni si trovano ad affrontare una sfida cruciale: come industrializzare la raffinazione dei dati senza costringere l’intero team aziendale a scrivere righe di codice SQL o Python complesso? Per molte aziende del Mid-Market, la carenza di profili IT iper-specializzati rappresenta un noto collo di bottiglia strutturale.
In questo scenario, l’adozione di Knime per data preparation si configura come una scelta strategica lungimirante. KNIME unisce la flessibilità di un approccio visivo e low-code al rigore analitico necessario per trasformare la materia prima informativa in un asset di valore inestimabile.
1. Knime ETL: Ottimizzare l’Infrastruttura sopra la Data Platform
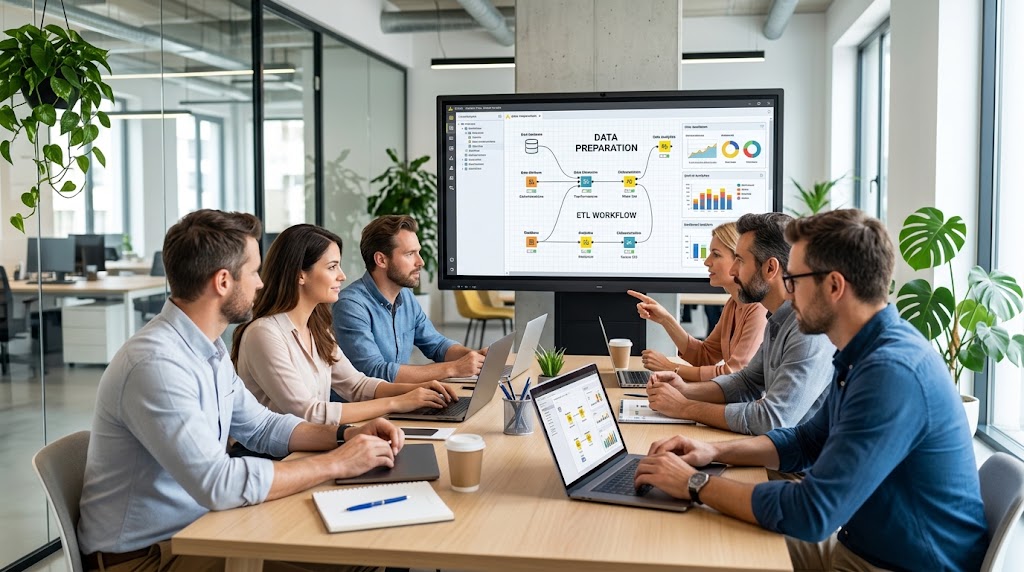
Quando un’azienda decide di consolidare il proprio patrimonio informativo all’interno di un’architettura moderna come il Data Lakehouse (ad esempio sfruttando la scalabilità cloud-native di Snowflake), la fase intermedia di trasformazione diventa il pilastro della strategia analitica. Se strumenti basati puramente sul codice richiedono una forte astrazione software, l’implementazione di pipeline di Knime ETL permette di costruire flussi di lavoro visivi, trasparenti e auto-documentanti.
Sopra una data platform centralizzata, KNIME agisce come un efficiente motore di orchestrazione e raffinamento:
Modellazione Multilivello: Consente di strutturare i dati secondo una logica a strati, separando lo staging dai livelli intermedi (intermediate) fino alla creazione dei data mart finali pronti per il business.
Push-Down Optimization: KNIME è in grado di tradurre i flussi visivi direttamente in query SQL eseguite nativamente all’interno del database cloud. In questo modo si sfrutta il disaccoppiamento tra calcolo e archiviazione tipico delle piattaforme moderne, ottimizzando i costi operativi senza spostare inutilmente i dati.
Integrazione AI e GenAI: Alimentare l’AI DATA CORE diventa lineare. I dati preparati tramite l’ETL visivo possono interfacciarsi direttamente con i modelli di Machine Learning o con framework avanzati come Snowflake Cortex o Databricks Genie, pronti per essere interrogati da web app conversazionali o agenti intelligenti.
2. Business Process Reengineering (BPR): La Data Preparation Indipendente
Il vero valore differenziante di KNIME risiede nella sua versatilità: non deve necessariamente dipendere da un’infrastruttura dati enterprise per esprimere il suo potenziale. Nelle iniziative di Business Process Reengineering (BPR), l’esigenza primaria del management è comprendere, ottimizzare e ristrutturare i flussi operativi partendo spesso da una situazione di forte frammentazione: sistemi ERP legacy, CRM disallineati e silos informativi inaccessibili.
Operare in modalità standalone e indipendente tramite KNIME offre alle PMI un enorme vantaggio tattico:
Data Discovery Agile: Prima ancora di investire in una migrazione cloud massiva, KNIME permette di mappare i processi “as-is” estraendo dati direttamente dalle sorgenti esistenti per identificare colli di bottiglia e inefficienze.
Automazione pulizia dati: Il tool risolve alla radice il problema del caos informativo. Attraverso nodi dedicati, l’automazione pulizia dati consente di normalizzare anagrafiche obsolete, riconciliare transazioni finanziarie divergenti ed eliminare record duplicati in modo del tutto autonomo e ripetibile, abbattendo drasticamente gli errori umani tipici dei processi manuali su fogli di calcolo.
Flessibilità Operativa: Il team di business e gli analisti di processo possono plasmare i dati in totale autonomia. Questo accelera i progetti di reingegnerizzazione senza sovraccaricare il dipartimento IT, evitando la creazione di soluzioni “tampone” non documentate che accumulano debito tecnico.
3. Guidare l’Innovazione con il Knime Data Science workflow
Il passaggio cruciale da una gestione puramente descrittiva del dato a una predittiva si compie attraverso la progettazione di un Knime Data Science workflow. Un flusso di lavoro in KNIME non si limita alle operazioni di pulizia e filtraggio, ma estende le sue capacità all’addestramento e al deployment di modelli predittivi all’interno della stessa interfaccia visiva.
[Sorgenti Dati] ➔ [Knime ETL & Pulizia] ➔ [Nodi Machine Learning] ➔ [Insight Predittivi / AI Core]
L’intero ciclo di vita del dato viene governato applicando i sani principi del paradigma DataOps. Ciascun nodo del workflow agisce come un blocco logico indipendente, facilmente ispezionabile e sottoposto a test di qualità automatici e sistematici (verificando ad esempio i parametri di unicità e non-nullità dei dataset).
In questo modo, l’azienda riduce il rischio di “data bug” o allucinazioni degli algoritmi, garantendo che i modelli predittivi (come le analisi di churn o la manutenzione predittiva) poggino su dati freschi, certificati e coerenti con le reali dinamiche del business.
Conclusioni
Sia utilizzato come motore di trasformazione visuale sopra un’architettura cloud evoluta, sia impiegato come strumento indipendente per ridisegnare i processi aziendali nel Business Process Reengineering, KNIME rappresenta una risposta concreta alle necessità del Mid-Market.
Abbinare l’automazione pulizia dati a un solido Knime Data Science workflow permette alle aziende di superare la gestione artigianale del patrimonio informativo. Il risultato è una vera e propria “fabbrica del dato” industriale: agile, sicura, democratica e nativamente pronta per le sfide della rivoluzione guidata dall’Intelligenza Artificiale.
Contattaci per scoprire come KNIME può aiutarti a ottimizzare
la preparazione dei dati e automatizzare i processi aziendali.